Enterprise agentic AI deployment faces a reliability paradox: while AI agents excel in demos and pilot projects, they often fail to deliver consistent performance at production scale. This inconsistency limits adoption and reduces business value.
AI agents can accurately process documents, generate insightful analysis, and automate complex workflows in controlled settings. However, in real-world production environments, they may produce unexpected failures, inconsistent outputs, and edge case errors, creating operational risks and eroding organizational confidence.
The underlying challenge is not AI capability but how prompts are designed, tested, and optimized. Prompt engineering—the craft of creating instructions that reliably elicit desired AI behavior—remains largely experimental in many enterprises. Teams rely on trial-and-error methods, lack systematic testing frameworks, and struggle to maintain prompt quality as business needs and models evolve.
Industry research shows 67% of enterprise AI projects fail to reach production, with unreliable prompts as a primary factor. Prompts that perform well in development often fail under real-world conditions:
- Handling actual customer data
- Managing edge cases
- Operating under production volume and latency constraints
For example, a financial services firm observed document processing agents performing at 94% accuracy in pilots, which dropped to 78% in production due to variations in document formats, data quality issues, and untested input patterns.
The solution is systematic prompt engineering frameworks that treat prompt development as rigorous engineering rather than creative experimentation. Organizations using structured approaches achieve:
- 95%+ reliability across diverse scenarios
- Reduced prompt development cycles from weeks to days
- Consistent performance at scale, turning AI capabilities into dependable production systems delivering sustained business value
Production Prompt Architecture: Engineering for Reliability
Reliable prompts at enterprise scale require architectural strategies beyond basic instruction crafting.
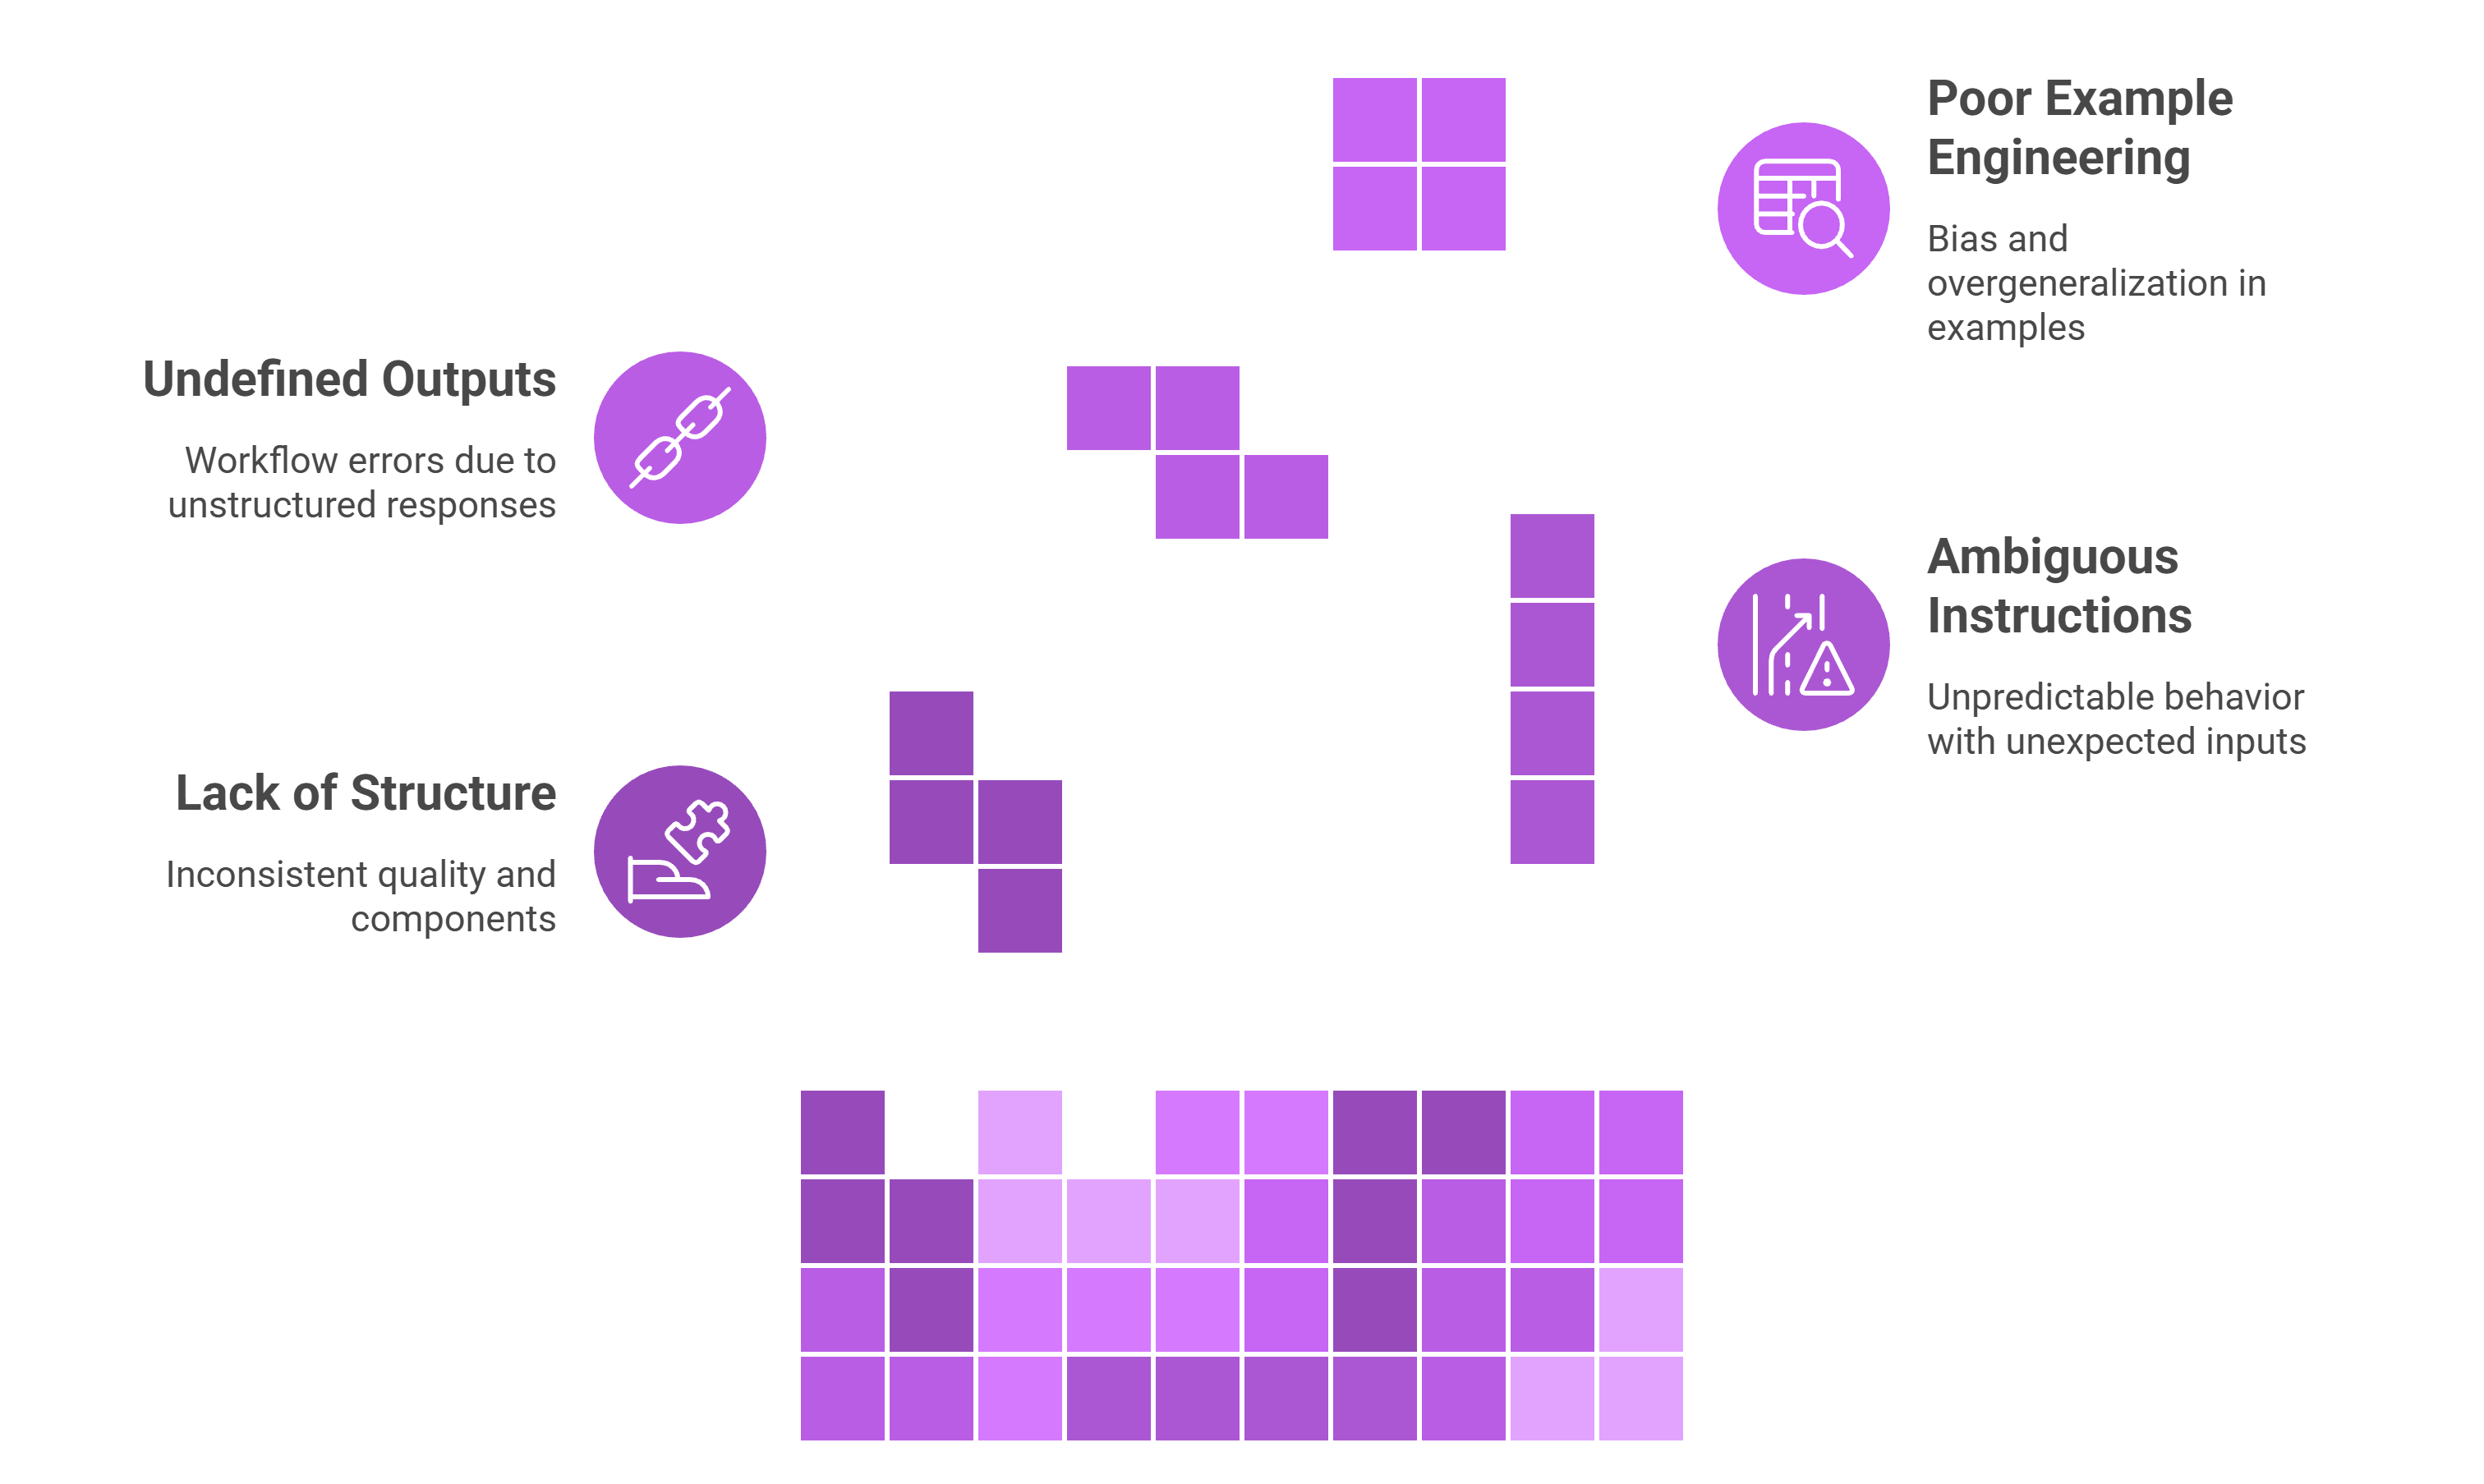
Structured Prompt Templates
Templates enforce consistency, quality, and essential components across all enterprise agents. Key elements include:
- Clear role definition
- Explicit instructions
- Output format specifications
- Constraint declarations
- Error handling guidance
Template-based design improves reliability, simplifies testing, and allows systematic optimization.
Example: SimplAI provides production-tested templates for document processing, data extraction, analysis generation, compliance verification, and conversational tasks. Templates are customized per enterprise requirements while maintaining architectural consistency for governance and optimization.
Contextual Grounding and Constraint Definition
Constraints explicitly define acceptable agent behavior:
- Which actions are allowed
- Required information sources
- Decision criteria
- Prohibited outputs
Ambiguous instructions lead to unpredictable behavior, especially with unexpected inputs.
Example: A healthcare documentation agent’s production prompt defines:
- Medical terminology and clinical note structure
- Patient privacy protections
- Information sources to reference
- Confidence thresholds triggering physician review
- Error handling procedures
This ensures reliable, compliant behavior across diverse clinical scenarios.
Output Format Specification and Validation
Structured outputs prevent workflow errors by defining:
- JSON schemas
- Required fields and data types
- Validation rules and format requirements
Validation logic ensures responses meet specifications before integration.
Multi-Shot Example Engineering
Curated examples demonstrate desired behavior across:
- Normal cases
- Edge cases
- Error conditions
- Ambiguous scenarios
Careful example selection avoids bias, overgeneralization, and context window issues.
Systematic Testing and Validation Frameworks
Achieving production reliability requires rigorous testing beyond happy-path demos.
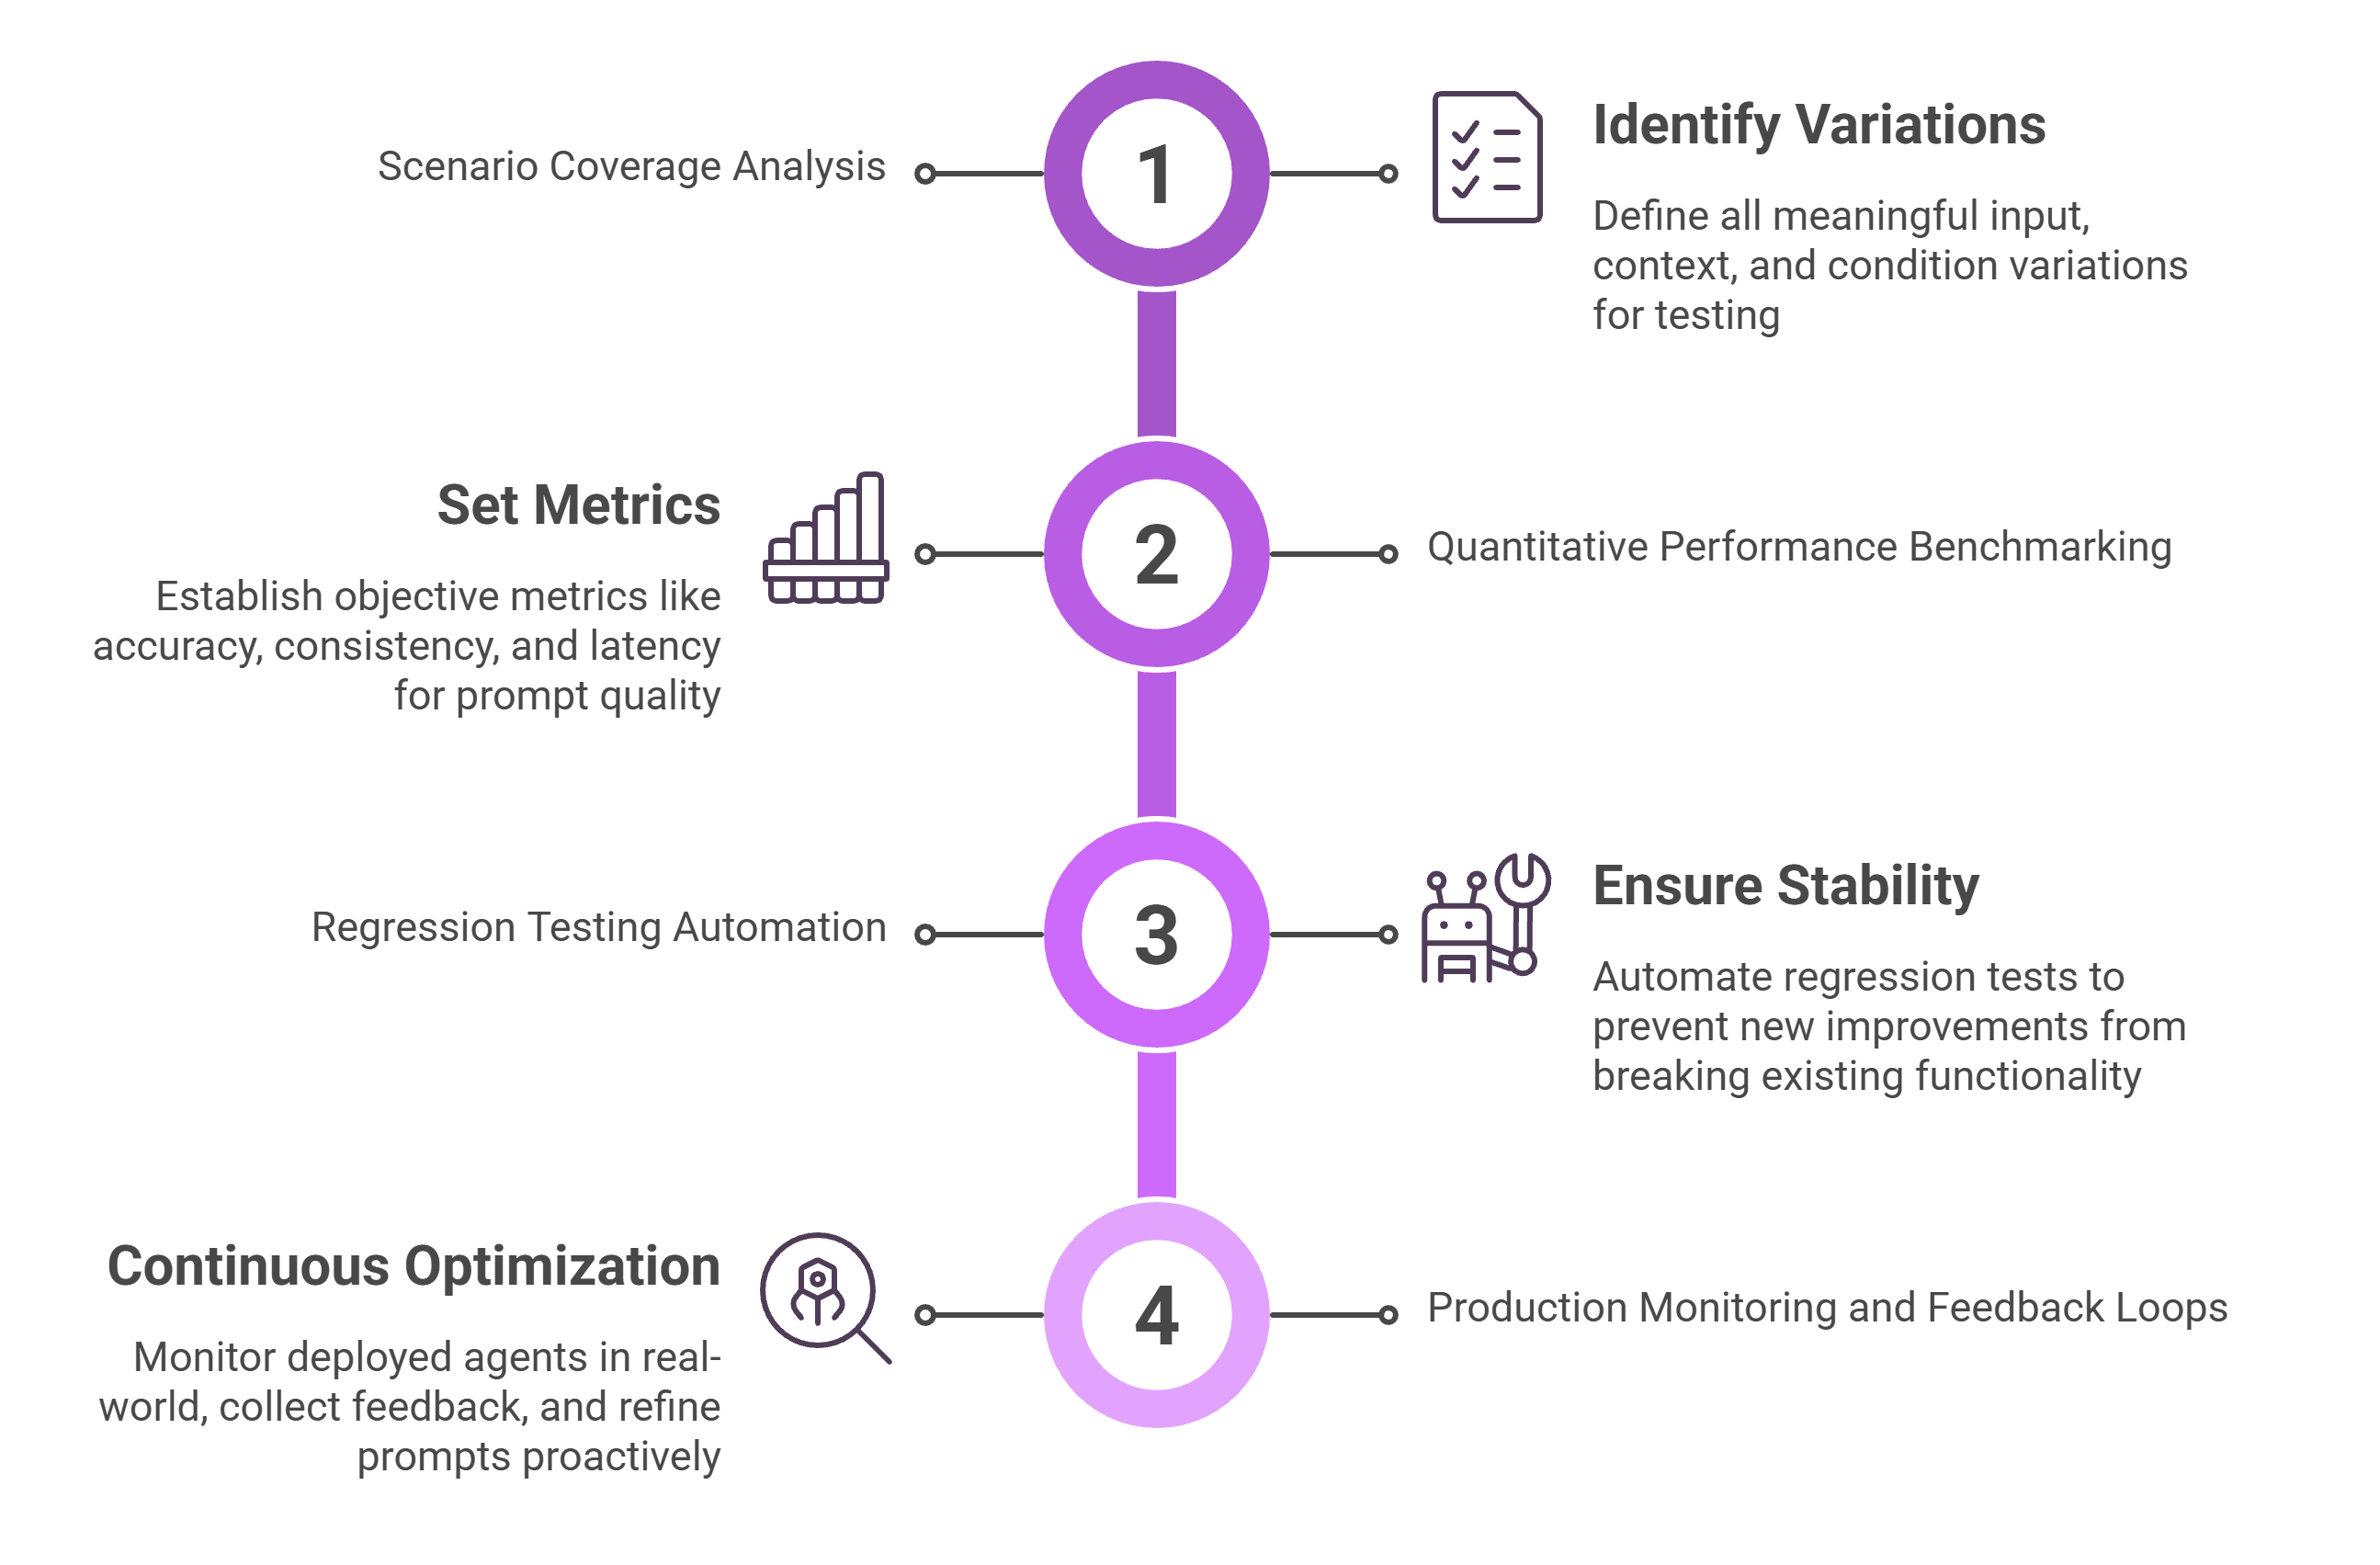
Scenario Coverage Analysis
Identify all meaningful variations in:
- Inputs
- Contexts
- Conditions
Comprehensive test suites include business process variations, data formats, edge cases, error conditions, and adversarial inputs.
Example: A financial document processing agent’s test suite covers:
- Standard and non-standard financial statements
- Poor scan quality or partial documents
- Multi-entity or foreign language documents
- Intentionally ambiguous cases
This reveals weaknesses before production deployment.
Quantitative Performance Benchmarking
Establish objective metrics for prompt quality:
- Accuracy rates
- Consistency across inputs
- Error rates per scenario
- Latency distributions
- Confidence calibration
Set minimum acceptable thresholds and track performance across iterations for data-driven optimization.
Regression Testing Automation
Automated regression ensures that prompt improvements in one scenario don’t degrade others. SimplAI executes comprehensive regression suites in minutes, enabling rapid iteration without compromising reliability.
Production Monitoring and Feedback Loops
Deployed agents are instrumented to monitor:
- Real-world performance
- Degradation patterns
- Emerging failure modes
- Feedback examples for prompt refinement
Continuous monitoring allows proactive optimization as inputs, models, or business contexts evolve.
Optimization Strategies: Systematic Performance Improvement
Prompt engineering involves continuous optimization using operational data, user feedback, and experimentation.
Failure Mode Analysis
Investigate incorrect outputs, categorize failure patterns, and refine prompts to address specific weaknesses.
Example: A contract analysis agent had an 8% error rate. Failure analysis revealed:
- Misclassified indemnification clauses: 4%
- Incorrect jurisdiction identification: 2.5%
- Missed force majeure provisions: 1.5%
Targeted refinements reduced overall errors to 2.1%, outperforming wholesale redesign.
A/B Testing and Prompt Variants
Compare alternative prompts empirically. Deploy competing variants across similar workloads and adopt the version with superior performance. This removes subjectivity from prompt engineering.
Confidence Calibration and Threshold Optimization
Tune agent confidence scores to reflect output reliability:
- High-confidence outputs: autonomous processing
- Low-confidence outputs: human review
Proper calibration balances automation efficiency with quality control.
Chain-of-Thought Decomposition
For complex reasoning tasks, prompts guide agents through sequential reasoning steps before generating final outputs. This improves reliability, allows process validation, and facilitates error diagnosis.
Production Operations: Maintaining Reliability at Scale
Maintaining reliability requires operational discipline beyond prompt engineering.
Version Control and Change Management
Treat prompts as code assets with:
- Configuration management
- Versioning
- Testing and approval workflows
- Rollback capabilities
Prevents ad-hoc changes that could break production systems.
Performance Degradation Detection
Automated monitoring detects performance declines before business impact, enabling rapid investigation and remediation.
Model Update Impact Management
Comprehensive test suites validate prompts across model updates, ensuring continued reliability as AI capabilities evolve.
Your Production Prompt Engineering Pathway
Achieving production-grade reliability requires:
- Auditing current prompt practices
- Identifying reliability gaps
- Establishing structured frameworks for prompt engineering, testing, and maintenance
SimplAI provides production-tested templates, automated testing infrastructure, monitoring tools, and optimization frameworks. Forward-deployed specialists help implement best practices and operational capabilities for reliable, enterprise-scale agents.
Frequently Asked Questions
Why do AI agents perform well in pilots but fail in production?
Pilot environments are controlled and limited. Production introduces diverse data, edge cases, and scale challenges that reveal prompt weaknesses.
What is structured prompt engineering?
It’s an architectural approach using templates, constraints, output specifications, and examples to ensure predictable, reliable agent behavior.
How is prompt reliability tested?
Through scenario coverage analysis, quantitative benchmarking, regression testing, and continuous monitoring.
How can failure modes be addressed?
By analyzing error patterns, refining prompts for specific weaknesses, and using A/B testing to select optimal variants.
Author bio